Curso de Inteligencia Artificial · Unidad 17 · Índice del curso completo de 24 unidades · Material didáctico para secundaria, Bachillerato y FP.
Bloque III · Aplicaciones avanzadas · Nivel intermedio-avanzado
Duración orientativa: 3 sesiones de 55 minutos.
Materiales: ordenador, navegador, hoja de cálculo o cuaderno. No se necesita programar.
Conocimientos previos: unidades 6, 8 y 12 (simulación, entrenamiento y decisiones).
Antes de empezar: aprender sin poner a nadie en peligro
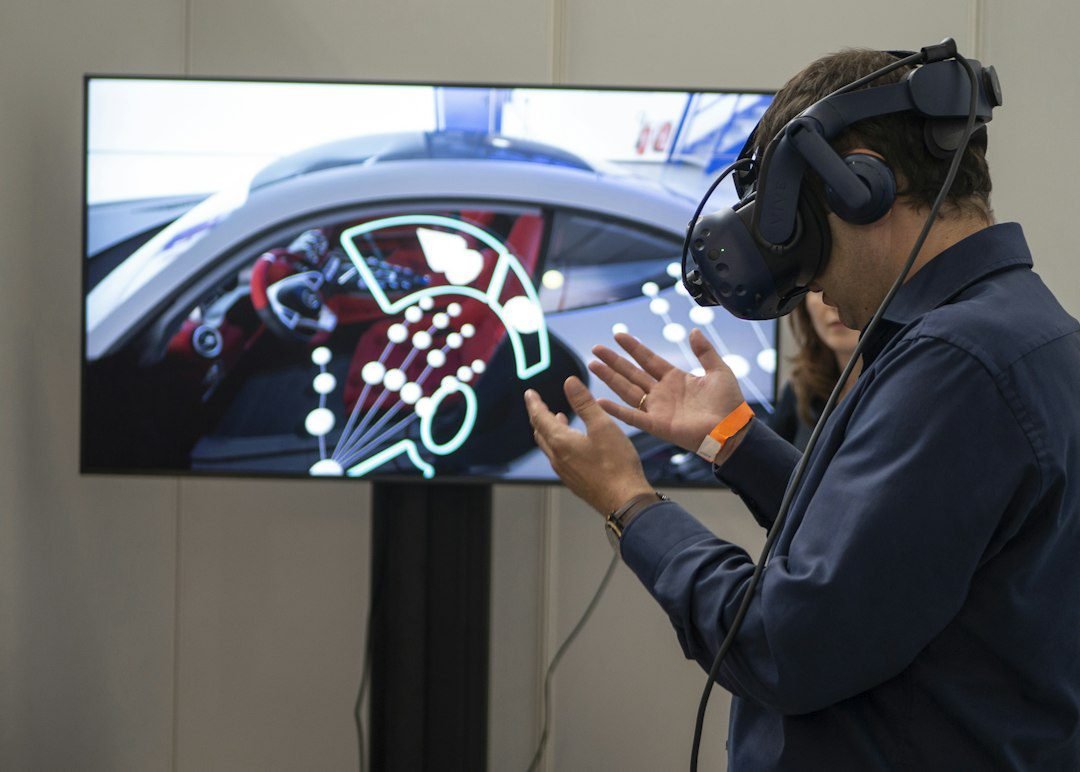
Imagina que queremos enseñar a un vehículo autónomo a frenar cuando una persona cruza la calzada. Una manera de obtener ejemplos sería conducir un automóvil real miles de veces, introduciendo peatones, lluvia y situaciones de peligro. Sin embargo, sería caro, lento y, sobre todo, inseguro. Otra opción consiste en construir una representación digital de la carretera, de los vehículos y de los peatones para ensayar las decisiones sin exponer a nadie al riesgo.
En esta unidad vamos a estudiar cómo los simuladores pueden ayudar a entrenar y evaluar sistemas de Inteligencia Artificial. También descubriremos dos formas diferentes de aprender: el aprendizaje supervisado, que parte de ejemplos con la respuesta correcta, y el aprendizaje por refuerzo, que obtiene información sobre las consecuencias de sus acciones.
Al terminar la unidad podrás: diferenciar simulación y mundo real; representar un problema mediante estados, acciones y resultados; comparar el aprendizaje supervisado y el aprendizaje por refuerzo; y diseñar un experimento que compruebe si una política de decisiones funciona.
17.1. ¿Qué es una simulación informática?
Una simulación es una representación de un sistema o de un proceso que permite observar cómo se comportaría bajo determinadas condiciones. No tiene que ser una copia perfecta de la realidad: debe conservar las características relevantes para el problema que queremos estudiar.
En un simulador de tráfico podemos representar una avenida mediante carriles, semáforos y vehículos. Los coches tendrán una posición y una velocidad, y podremos variar el tiempo que tarda el semáforo en cambiar de color. Con esos datos, el programa calcula lo que sucede después. En un simulador de incendios, en cambio, interesarán la temperatura, la dirección del viento y la propagación del fuego.
Los modelos pueden basarse en reglas físicas, en datos históricos, en modelos de IA o en una combinación de estos elementos. Por tanto, simulación e IA no son sinónimos. Un programa que calcula el movimiento de un objeto usando fórmulas físicas está simulando, aunque no utilice aprendizaje automático.
| Elemento | Ejemplo en un simulador de reparto |
|---|---|
| Estado del entorno | Posición del robot, carga de batería y obstáculos |
| Acción posible | Avanzar, girar, esperar o regresar |
| Reglas del modelo | Velocidad máxima y consumo de batería |
| Resultado observable | Entrega completada, choque, retraso o gasto energético |
| Objetivo | Entregar todos los pedidos con seguridad y eficiencia |
17.2. ¿Para qué sirve simular antes de entrenar?
El valor de una simulación no es solamente ahorrar materiales. También permite repetir experimentos bajo las mismas condiciones, cambiar una variable y registrar resultados. En un entorno real, dos trayectos nunca son completamente iguales: puede haber más tráfico, cambiar la luz o surgir un obstáculo imprevisto.
Con una simulación podemos estudiar situaciones poco frecuentes pero importantes, como una parada de emergencia, un sensor que deja de funcionar o una carretera mojada. También podemos preparar pruebas de estrés antes de desplegar una aplicación. Por ejemplo, un robot puede comportarse correctamente en una sala vacía y fallar cuando entra un grupo de personas.
No obstante, existe una limitación fundamental: el simulador puede equivocarse. Si sus reglas describen mal el rozamiento o no contemplan el comportamiento de una persona, el modelo aprenderá sobre un mundo que no se corresponde del todo con la realidad. Este salto entre el entorno simulado y el real suele llamarse brecha entre simulación y realidad (sim-to-real gap).
Por esa razón, antes de usar un modelo en el mundo real se necesitan pruebas adicionales, supervisión y medidas de seguridad. Un resultado excelente dentro del simulador no garantiza un funcionamiento seguro fuera de él.
17.3. Aprendizaje supervisado: aprender con ejemplos
En el aprendizaje supervisado proporcionamos al modelo parejas de entrada y respuesta esperada. Durante el entrenamiento, el algoritmo compara la salida que ha obtenido con la respuesta correcta y ajusta el modelo para reducir los errores.
Supongamos que enseñamos a un vehículo qué hacer cuando se aproxima a un semáforo. Registramos la distancia al cruce, la velocidad y el estado de la señal. Un instructor añade la acción apropiada para cada ejemplo. El modelo aprende a relacionar las observaciones con decisiones como «frenar», «mantener velocidad» o «detenerse».
| Distancia al semáforo | Velocidad | Señal | Acción indicada en el ejemplo |
|---|---|---|---|
| 30 m | 20 km/h | Rojo | Frenar |
| 70 m | 15 km/h | Verde | Continuar con precaución |
| 12 m | 35 km/h | Amarillo | Evaluar distancia de parada y seguridad |
Esta tabla es didáctica y no contiene instrucciones reales de conducción. En un sistema verdadero, la decisión dependería de normas viales, tiempo de reacción, adherencia y otros vehículos.
La calidad de los ejemplos es crucial. Si todos los registros proceden de días soleados, puede que el sistema no generalice bien en lluvia. También es indispensable separar datos de entrenamiento, de validación y de prueba para evitar evaluar el modelo únicamente con casos que ya conoce.
17.4. Aprendizaje por refuerzo: aprender mediante consecuencias
En el aprendizaje por refuerzo, un agente toma decisiones dentro de un entorno. Después de actuar, observa qué ha cambiado y recibe una señal de recompensa. Su objetivo es aprender una estrategia o política que consiga una buena recompensa acumulada a lo largo del tiempo.
Piensa en un robot de reparto que debe llevar un paquete de la base al aula. Al avanzar una casilla consume batería; al chocar pierde puntos; al llegar al destino obtiene una recompensa. Al principio puede probar recorridos poco eficientes. Con la experiencia, modifica su estrategia y descubre rutas más convenientes.
→
→
El aprendizaje por refuerzo no necesita que un docente etiquete de antemano cada acción como correcta o incorrecta. Pero eso no significa que funcione «sin datos»: necesita experiencias, observaciones, recompensas y un entorno. Además, diseñar mal las recompensas puede provocar comportamientos inesperados. Si premiamos al robot únicamente por terminar rápido, podría escoger un recorrido inseguro.
17.4.1. Una función de recompensas sencilla
Para un ejercicio escolar podemos definir la siguiente escala. Son valores inventados para el experimento y no medidas universales de calidad:
| Suceso | Puntos |
|---|---|
| Llega al destino | +10 |
| Avanza una casilla | −1 |
| Choca contra un obstáculo | −8 |
| Entra en una zona prohibida | −12 |
Si el robot llega tras cinco movimientos, obtiene 10 − 5 = 5 puntos. Si realiza tres movimientos y choca, obtiene −3 − 8 = −11 puntos. Así podemos comparar los resultados de varias estrategias. La política óptima depende de cómo se hayan definido las recompensas.
17.5. Aprendizaje supervisado y por refuerzo: diferencias
Ambos métodos permiten entrenar modelos, pero la información recibida durante el aprendizaje es diferente.
| Aspecto | Supervisado | Por refuerzo |
|---|---|---|
| Información principal | Ejemplos de entrada con su respuesta | Consecuencias de acciones y recompensas |
| Pregunta central | «¿Qué respuesta corresponde?» | «¿Qué acción conviene realizar ahora y después?» |
| Ejemplo | Clasificar imágenes de señales | Elegir una ruta y evitar obstáculos |
| Problema frecuente | Etiquetas erróneas o datos poco representativos | Recompensas mal diseñadas o exploración insegura |
| Evaluación | Precisión sobre casos nuevos | Recompensa acumulada, seguridad y cumplimiento de objetivos |
Una solución real puede combinar técnicas. Un robot puede reconocer señales mediante un modelo supervisado y decidir cómo desplazarse mediante otro sistema de planificación o aprendizaje por refuerzo.
17.6. Del simulador al mundo real
Antes de trasladar una IA entrenada en un entorno virtual a un dispositivo físico, debemos preguntarnos si los datos y las reglas de simulación reflejan los casos que encontrará. En un aula, un robot podría recorrer un pasillo perfectamente recto. En el centro educativo real aparecerán mochilas, puertas, mobiliario y personas. El aprendizaje debe contemplar esa variabilidad.
Una técnica útil es variar las condiciones durante el entrenamiento: posición de los obstáculos, iluminación, velocidad, ruido de los sensores y estado de la batería. Esto ayuda a reducir la dependencia de unas pocas condiciones ideales. Aun así, se necesitan pruebas reales controladas y sistemas de parada seguros.
Los resultados deben registrarse con indicadores concretos: porcentaje de entregas completadas, número de colisiones, tiempo medio, consumo de energía y fallos en condiciones nuevas. Medir solamente el tiempo no sería suficiente para afirmar que un robot funciona bien.
Actividad 1. Diseña un entorno simulado para un robot escolar
Objetivo: identificar estados, acciones, recompensas y riesgos. Tiempo: 20 minutos. Trabajo: parejas.
- Dibuja una cuadrícula de 5 × 5 casillas. Sitúa el inicio en la esquina superior izquierda y la meta en la esquina inferior derecha.
- Coloca cuatro obstáculos. Marca una casilla como zona prohibida.
- Establece un conjunto de acciones: arriba, abajo, izquierda y derecha. No se puede atravesar una pared.
- Utiliza las recompensas propuestas en el apartado 17.4.1 o justifica otras.
- Propón dos rutas distintas y calcula la recompensa total de cada una.
- Explica qué cambiaría si se colocara un obstáculo nuevo a mitad del recorrido.
Entrega: cuadrícula, tabla de dos rutas, cálculos y explicación de cuál elegirías y por qué.
Actividad 2. Laboratorio de recompensas: ¿siempre gana la ruta corta?
Objetivo: comprobar que una buena decisión depende del criterio de evaluación. Tiempo: 25 minutos.
Tenemos dos rutas simuladas hacia el mismo destino. La ruta A requiere cuatro movimientos, pero tiene una zona de riesgo que provoca una penalización adicional de −6 puntos. La ruta B necesita siete movimientos y no atraviesa zonas de riesgo. En ambas, llegar al destino suma +10.
- Calcula los puntos de A y B aplicando −1 por movimiento.
- Decide qué ruta escogería un agente que busca la máxima recompensa.
- Modifica la penalización de riesgo a −2 y repite el cálculo.
- ¿Qué aspecto del diseño cambió la decisión del agente? ¿Por qué no basta con decir que una IA «aprende lo correcto»?
- Propón una condición que obligue a descartar una ruta aunque obtenga muchos puntos.
Entrega: operaciones y reflexión de entre 100 y 150 palabras.
Actividad 3. Plan de evaluación de una IA entrenada con simulaciones
Objetivo: diseñar una prueba rigurosa. Tiempo: 30 minutos. Trabajo: grupos de tres.
Una empresa ha desarrollado un robot que reparte medicamentos en un hospital virtual. Ha conseguido completar 48 de 50 repartos en un pasillo despejado. Afirma que ya puede utilizarse sin supervisión.
- Calcula el porcentaje de éxito y explica qué demuestra realmente ese dato.
- Indica cuatro situaciones nuevas que deberían ensayarse: personas cruzando, obstáculos, fallos de sensor, baterías bajas u otras.
- Propón tres indicadores además de entregas completadas.
- Diseña una tabla con las columnas: escenario, número de pruebas, éxitos, colisiones, observaciones.
- Redacta una conclusión sobre si los datos disponibles justifican desplegar el robot.
Ampliación: investiga qué significa sobreajuste y explica cómo podría aparecer en este caso.
Comprueba lo aprendido
- ¿En qué se diferencia un simulador de un sistema de IA?
- ¿Por qué es importante que una simulación reproduzca las condiciones relevantes del mundo real?
- ¿Qué información necesita un modelo supervisado para entrenarse?
- ¿Qué son un agente, un entorno y una recompensa en aprendizaje por refuerzo?
- ¿Un agente que obtiene una recompensa elevada es necesariamente seguro? Razona tu respuesta.
- Pon un ejemplo en el que una prueba real controlada sea imprescindible antes de utilizar una IA.
En resumen
La simulación permite experimentar con un entorno representado mediante un modelo informático. En aprendizaje supervisado, el sistema aprende a partir de ejemplos con respuestas conocidas. En aprendizaje por refuerzo, un agente mejora su política a partir de acciones, observaciones y recompensas. La utilidad de ambos enfoques depende de cómo definamos el problema y de cómo evaluemos los resultados. Un modelo que funciona dentro de un simulador debe someterse a pruebas adicionales antes de utilizarse en situaciones reales.
Fuentes y créditos
- Education Bureau (Hong Kong) y The Chinese University of Hong Kong (2023). Module on Artificial Intelligence for Junior Secondary Level, Booklet 3, Unit 2, pp. 28–35. Material curricular de referencia.
- Desarrollo original para TICenelAula: explicación adaptada, datos de las tablas, cuadrículas y actividades didácticas. Los ejemplos de puntuación son simulaciones escolares, no instrucciones de uso real.